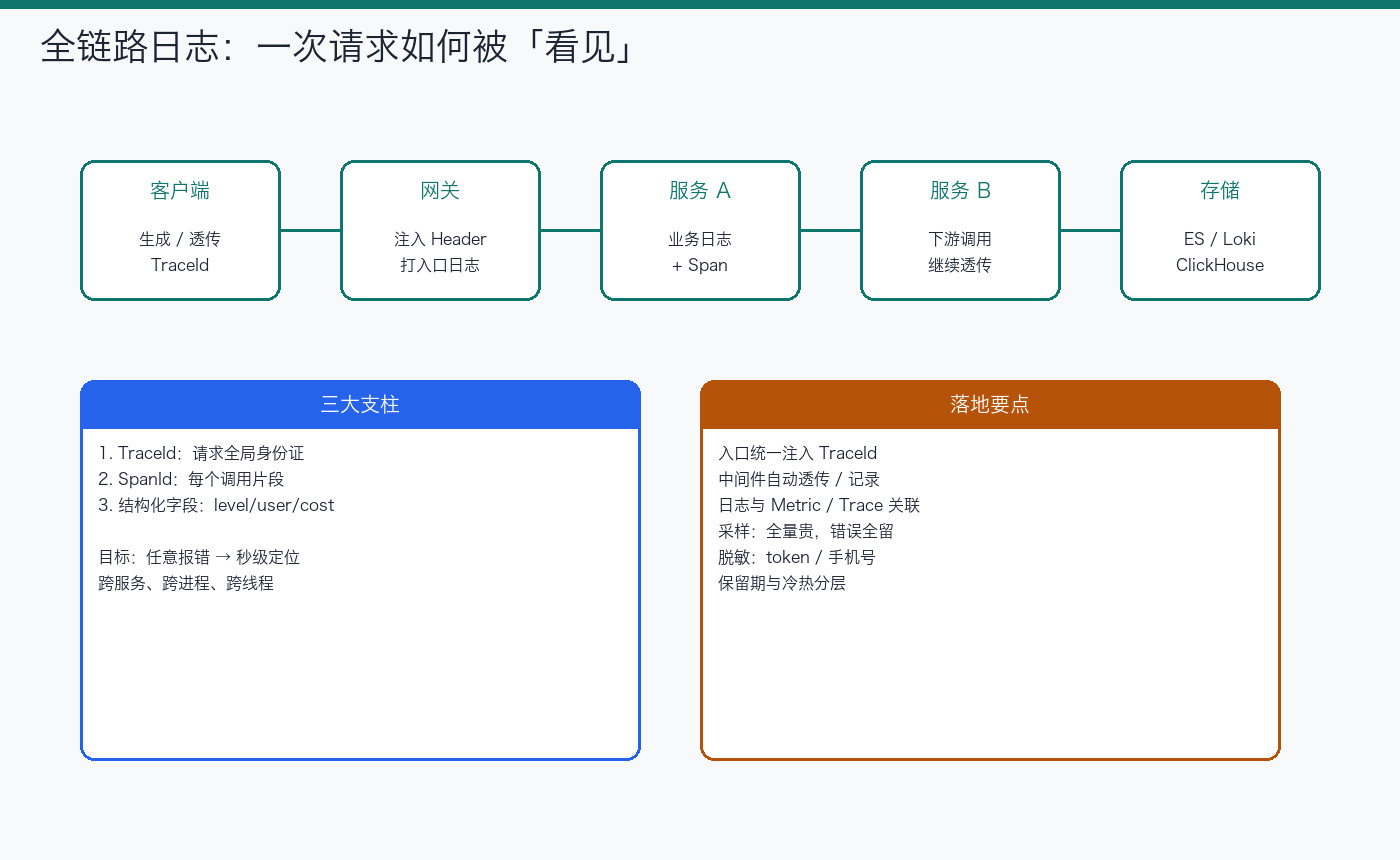
用户只看到「下单失败」。背后可能穿过网关、订单、库存、支付和消息队列。若每个系统各写各的日记本,工程师就只能拿时间戳人肉拼图——全链路日志,就是给这次请求发一张全球通行证。
一句话:统一 TraceId、自动透传、结构化可检索;让故障从「搜日志」变成「还原一次请求」。
从“搜日志”到“还原一次请求”
普通日志回答“这个服务发生了什么”;全链路日志还要回答:
- 这条日志属于哪次用户请求?
- 请求经过了哪些服务和步骤?
- 时间耗在哪里,错误从哪里开始传播?
- 异步消息、重试和批处理如何关联回来?
三个概念最关键:
| 字段 | 含义 |
|---|---|
| TraceId | 一条端到端链路的全局标识 |
| SpanId | 链路中一次操作的标识,如一次 RPC 或 SQL |
| ParentSpanId | 当前 Span 的父操作,用于还原调用树 |
一次请求可看成一棵树:
1 | Trace 7f3a... |
所有节点共享 TraceId,但 SpanId 不同。只记录 TraceId 能把日志搜齐;加入 Span 父子关系,才能看清调用结构与耗时。
一套典型架构
全链路可观测通常包含三类信号:
- Logs:离散事件和上下文,适合解释“为什么”;
- Metrics:聚合数字和趋势,适合发现“是否异常”;
- Traces:请求路径与耗时,适合定位“慢在哪里”。
典型数据流如下:
1 | 应用 SDK / Agent |
采集器应与应用解耦。应用只负责规范输出,Agent 或 Collector 负责批量、缓冲、重试和路由,后端负责索引、存储与查询。
OpenTelemetry 提供厂商中立的 API、SDK 和传输规范。实践中可采用 W3C Trace Context,用 HTTP 头传播:
1 | traceparent: 00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01 |
字段依次包含版本、Trace ID、父 Span ID 和采样标志。不要自创十几套 X-Request-Id 协议;若历史系统已有 request ID,可以保留并映射,但链路传播尽量统一。
上下文如何跨边界传播
同步 RPC 最简单:调用方把 Trace Context 注入 HTTP/gRPC 头,被调用方提取后创建子 Span,响应返回时结束 Span。
异步场景更容易断链:
- 生产者创建“发送消息”Span;
- 把 trace 上下文写入消息 Header,而非业务正文;
- 消费者提取上下文,创建“处理消息”Span;
- 重试时保留原始关联,同时记录 retry count;
- 批量消费可用 Span Link 关联多个上游,而不是硬造一个父节点。
线程池、协程与定时任务也要注意上下文丢失。不要假设 ThreadLocal 能自动跨线程;应使用框架的 context propagation 能力,或显式传递不可变上下文。
链路入口若没有上游 TraceId,就生成新的;收到格式非法或不可信的外部 TraceId 时,应校验并限制长度,避免日志注入与索引污染。
结构化日志:让机器能理解
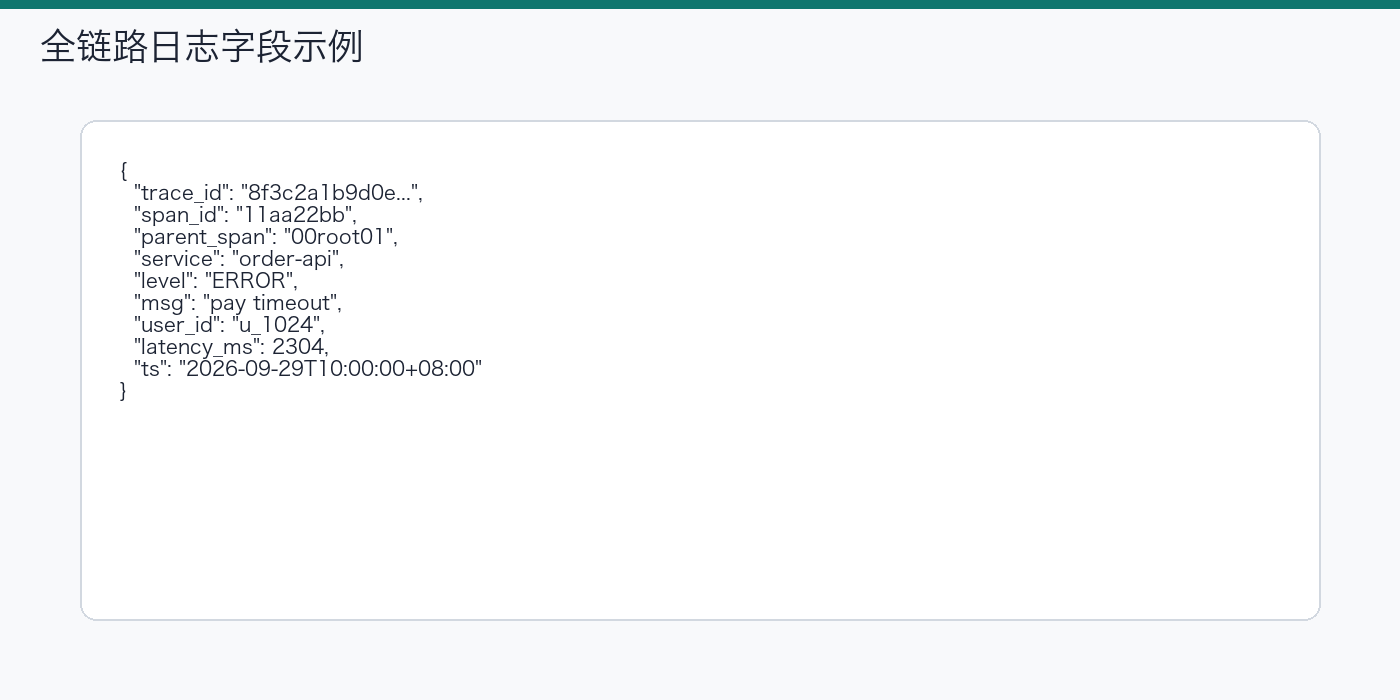
下面两行对人都能看懂,但只有后一种适合稳定查询:
1 | 下单失败,用户 42,商品 9001,库存不足 |
推荐的基础字段:
| 类别 | 字段示例 |
|---|---|
| 时间 | timestamp,统一 UTC 或明确时区 |
| 级别 | level:DEBUG/INFO/WARN/ERROR |
| 服务身份 | service.name、service.version、environment |
| 链路 | trace_id、span_id |
| 事件 | event、message、error.type、error.stack |
| 请求 | http.method、http.route、status_code、duration_ms |
| 业务 | order_id、tenant_id 等稳定标识 |
message 用于人读,字段用于机器查。不要把所有信息都塞进一句可变文本,更不要把动态订单号放进字段名。
一个较完整的示例:
1 | { |
日志 Schema 应版本化并有负责人。字段命名可优先参考 OpenTelemetry Semantic Conventions,减少不同团队的 cost、latency、elapsed 三套同义词。
日志级别与错误记录
级别不是情绪,而是运维契约:
DEBUG:调试细节,生产通常按需开启;INFO:关键业务状态变化与生命周期事件;WARN:已降级或可恢复,但值得关注;ERROR:本次操作失败,需要调查;FATAL:进程无法继续。
同一异常不要每层都打印完整堆栈。底层可以包装错误并返回,上层在真正处理或终止请求的边界记录一次,否则一个故障会制造几十条重复 ERROR,污染告警。
日志还要避免两种极端:入口、出口、每个变量都打,成本失控;只在 catch 里写“失败了”,没有参数、耗时和错误类型,无法定位。
采样:省成本但别丢掉真相
流量很大时,保存每个 Trace 和每条 DEBUG 日志并不现实。
头部采样
请求刚进入系统就决定是否采样,例如保留 1%。优点是开销低、整条链路决策一致;缺点是无法提前知道这次请求最终会不会报错。
尾部采样
Collector 暂存完整 Trace,结束后再决定:
- 错误请求 100% 保留;
- 高延迟请求提高比例;
- 普通成功请求只保留少量;
- 特定租户或灰度版本按规则保留。
尾部采样更聪明,但需要内存、等待窗口和集中式决策。无论哪种,都要传播采样标志,避免上游采了、下游没采。
日志采样不能简单随机扔掉 ERROR。对重复错误可按指纹限速,同时记录被抑制数量;审计日志与计费记录更不能因采样消失。
隐私与安全
日志系统往往比业务库更容易被广泛查询,因此也是数据泄露高风险区。默认禁止记录:
- 密码、Token、Cookie、私钥;
- 完整身份证、银行卡、手机号;
- 请求或响应的完整敏感正文;
- 未经批准的用户内容。
推荐在源头做字段白名单和脱敏,而不是指望采集端用正则补救。哈希也不是万能匿名化:手机号空间有限,普通 SHA-256 很容易被字典反查;需要关联统计时应使用带密钥的 HMAC,并管理密钥轮换。
日志查询要有最小权限、审计记录、保留周期和自动删除策略。开发环境与生产环境应分开索引,导出日志同样要审批和脱敏。
性能与可靠性
日志代码不能反过来拖垮业务:
- 异步批量写,设置队列上限;
- 后端不可用时限速或落盘缓冲;
- 明确“队列满时丢低级日志还是阻塞业务”;
- 限制单条大小与异常堆栈长度;
- 避免对每个高基数字段建立索引。
user_id、trace_id 很有查询价值,但 URL 原文、SQL 原文、随机错误消息可能造成索引基数爆炸。可把 http.route=/users/{id} 作为聚合字段,把原始路径仅作为非索引字段或干脆不记。
系统自身也要可观测:采集延迟、丢弃条数、队列长度、解析失败率、存储容量、查询 P95 都应有指标与告警。
实施清单
第一阶段:先做到“串得起来”
- 统一入口生成或接收 W3C Trace Context;
- HTTP、RPC、MQ 自动注入与提取;
- 所有结构化日志自动带
trace_id/span_id; - 网关到核心服务跑通一条可查询链路。
第二阶段:让数据可用
- 定义日志 Schema、级别与脱敏规范;
- 接入 OpenTelemetry Collector;
- 建立按服务、版本、路由和错误类型的面板;
- 告警可一键跳转到对应 Trace 和日志;
- 用故障演练验证跨线程、MQ、重试不会断链。
第三阶段:治理成本
- 按价值设置采样策略;
- 管理索引与冷热保留周期;
- 监控采集丢失和 Schema 解析失败;
- 定期扫描敏感字段与无效日志;
- 用每 GB 成本、检索命中率和故障定位时间衡量收益。
小结
全链路日志不是“给每行加一个 TraceId”就结束了。它是一整套上下文传播、结构化 Schema、采集管道、采样策略和安全治理。
成熟系统的体验应该是:从一个告警进入,先看指标确认范围,再打开 Trace 找到最慢或出错的 Span,最后跳到同一 TraceId 的结构化日志解释原因。三类信号互相跳转,才真正把“日志海洋”变成故障证据链。