凌晨两点,告警群炸了:CPU 打满、接口超时。你会敲的第一串命令,往往决定接下来是十分钟定位,还是两小时盲人摸象。
Linux 命令不该背成字典,而该装成一张地图:出了事知道往哪走,写脚本知道用哪块积木。
一句话:先「看见」系统,再「控制」进程与文件,最后用管道把小命令织成排查套路。
为什么要有命令地图
新手容易陷入两极:要么只记得 ls、cd、vim,线上故障手足无措;要么收藏 200 条 alias,真出事仍不知道从哪下刀。
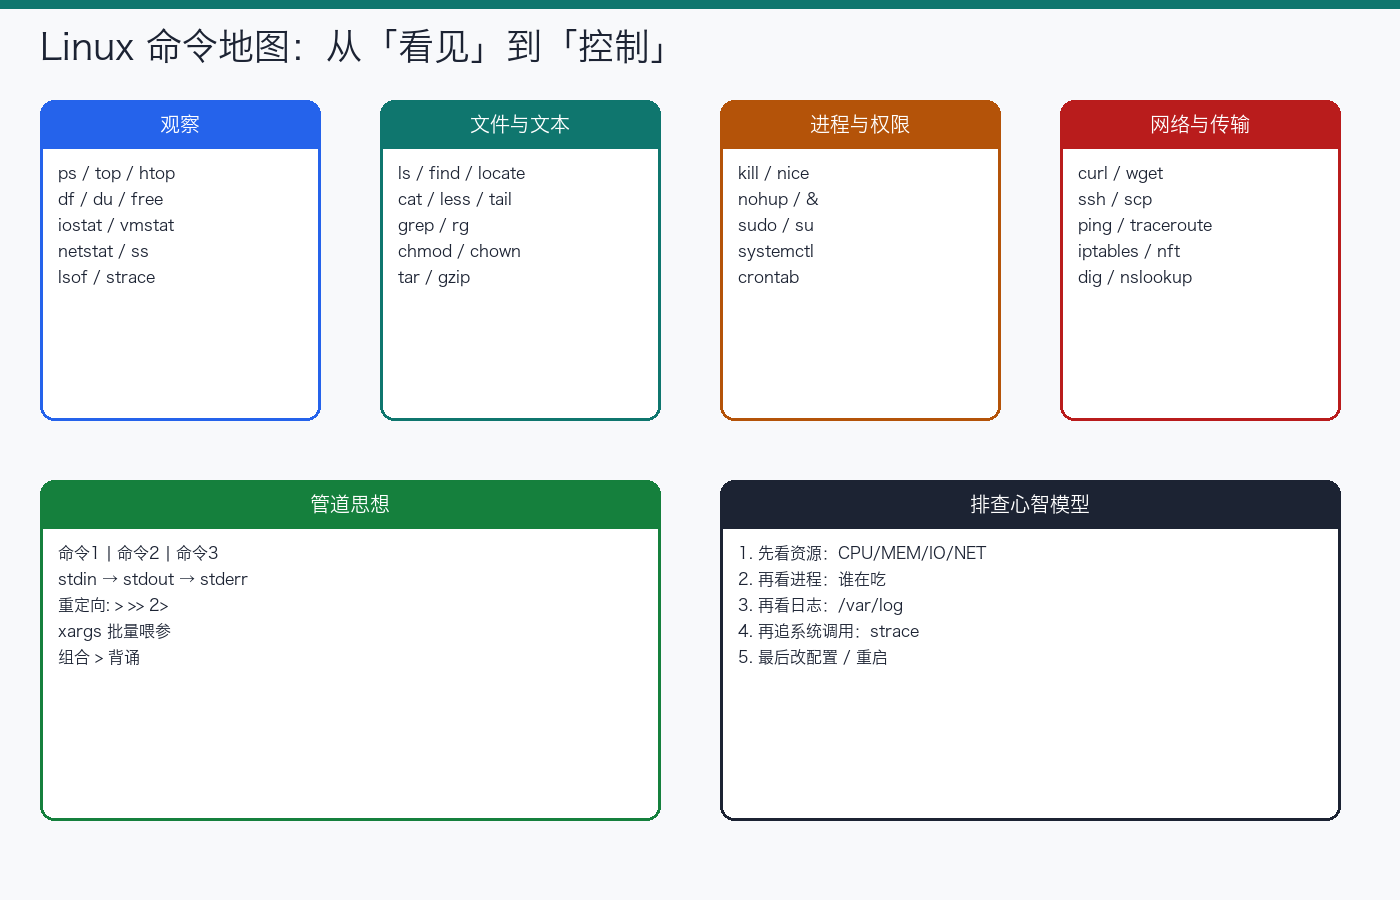
更稳的做法是按意图分组:
| 意图 | 你在问什么 | 典型命令 |
|---|---|---|
| 观察 | 机器现在怎样 | top free df ss |
| 定位 | 谁在搞事 | ps lsof strace |
| 操作 | 改文件/权限/服务 | chmod systemctl kill |
| 连接 | 网络通不通 | ping curl dig |
| 组合 | 把线索串起来 | ` |
观察类:先把「仪表盘」打开
进程与负载
1 | top # 交互式看 CPU/MEM 排行 |
load average 要结合 CPU 核数看:8 核机器 load 长期 > 8,才值得紧张。
内存与磁盘
1 | free -h |
线上经典坑:根分区 100% 导致写日志失败,服务「假死」。
网络与句柄
1 | ss -lntp # 谁在听端口(替代老 netstat) |
文件与文本:日志是第一现场
1 | tail -n 200 app.log |
权限三件套:
1 | ls -l |
打包传输:
1 | tar -czf backup.tgz ./conf |
进程与权限:温和地「动手」
1 | kill -15 <pid> # SIGTERM,给机会收尾 |
原则:先 TERM 再 KILL;先看依赖再重启;生产变更要可回滚。
网络与传输
1 | ping -c 4 8.8.8.8 |
DNS / 超时 / 证书 / 代理,四个方向把「打不开」拆开。
管道思想:命令的真正威力
1 | cat access.log \ |
三条铁律:
- 一个命令只做一件事,用管道拼接
- 分清三个流:stdin / stdout / stderr(
2>重定向错误) xargs把行变成参数:find . -name '*.log' | xargs du -sh
排查心智模型(可背)
- 资源:CPU / 内存 / 磁盘 / 网络有没有顶满
- 进程:谁在吃资源,是否重启循环
- 日志:应用日志 + 系统日志(
journalctl -u svc) - 系统调用:
strace -p <pid>看卡在 read/connect/futex - 配置与变更:最近发版、开关、证书、依赖是否变更
三个实战排查
磁盘满了,但 du 对不上
先用 df -hT 找到满的挂载点,再从挂载点开始逐层 du -xhd1。-x 可以避免跨到其他文件系统。若 df 显示已满,而 du 加起来明显偏小,常见原因是文件已经被删除,但进程仍持有打开的文件描述符:
1 | lsof +L1 |
确认进程和文件后,优先让应用重新打开日志或优雅重启,不要直接操作 /proc/<pid>/fd。如果空间没满但无法新建文件,再用 df -ih 检查 inode;大量小文件会先耗尽 inode。
接口访问失败
不要把“网络不通”当成一个问题,要逐层验证:
1 | dig +short api.example.com |
DNS 有结果只说明解析成功;TCP 连通只说明端口可达;curl -v 才能继续观察 TLS 握手、证书、HTTP 状态和响应耗时。ping 失败也不能直接判定服务宕机,因为很多网络会禁用 ICMP。
如果连接在客户端超时,同时服务端看不到请求,检查路由、安全组和防火墙;若已建立 TCP 但 HTTP 长时间无响应,再看服务线程、连接池和下游依赖。
CPU 高与负载高不是一回事
top 中某进程 CPU 高,说明它确实在计算;load average 高则还可能是大量任务等待不可中断 I/O。可以组合观察:
1 | vmstat 1 |
vmstat 的 r 表示运行队列,wa 反映 I/O 等待;pidstat 区分 CPU 与磁盘行为;top -H 定位热点线程。Java 进程还可以把十进制线程 ID 转为十六进制,再和线程栈对应。结论要由多条证据互相支持,而不是看到 load 高就立刻扩 CPU。
命令行的安全边界
生产命令不仅要“能跑”,还要考虑误操作。批量删除前先把 -delete 换成 -print 预览;批量处理文件名时用 NUL 分隔:
1 | find logs -type f -name '*.log' -print0 | |
脚本中的变量必须引用:
1 | rm -- "$file" |
而不是 rm $file。-- 阻止以连字符开头的文件名被当作选项。对复杂脚本启用 set -euo pipefail,但仍要显式处理允许失败的命令。涉及重启、权限、删除和覆盖时,记录操作前后的状态,并准备回滚方式。
还有一条容易忽视:不要在命令行参数中直接放密码或 Token,它们可能被 shell 历史和进程列表看到。优先使用权限受控的配置文件、标准输入或密钥管理系统。
从一次性命令升级为脚本
命令行适合探索,脚本适合重复。当一条管道进入定时任务或开始修改数据,就应补上参数校验、退出码、日志和互斥机制。先在小样本与只读模式下验证,再扩大范围。
也不要强迫 Shell 处理所有格式:JSON 用 jq,YAML 用 yq,复杂 CSV 用专用解析器;涉及复杂状态、并发和测试时,Python、Go 往往更清晰。优秀的 Linux 使用者不只会更多命令,也知道什么时候该停止堆管道。
小结
Linux 命令学到最后,比拼的不是条数,而是问题分解能力。把地图装进脑子:观察 → 定位 → 操作 → 验证。
下次告警再来,先问自己三句:
- 资源哪一项先顶满?
- 是谁在吃、卡在什么调用?
- 最近变更是什么?
答得清,命令只是手脚;答不清,命令再多也是盲人摸象。