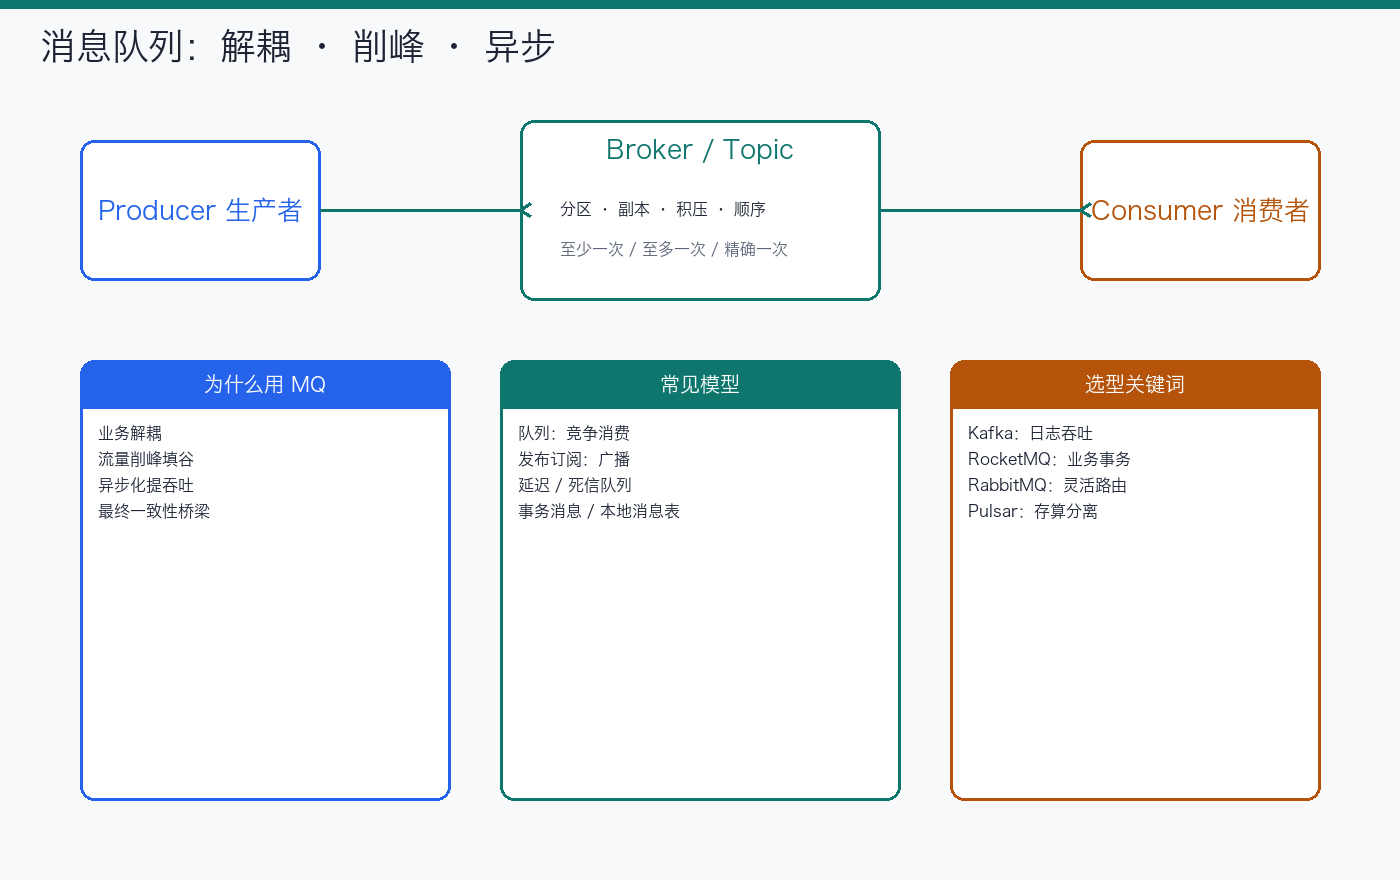
下单接口同步串了写订单、扣库存、发券、推送、更新画像——任何一个非核心依赖咳嗽,用户都在转圈。消息队列出场,不是为了「时髦」,是为了把这件事拆开:先记下发生了什么,再让别人按节奏办。
一句话:MQ 用异步换解耦与削峰,也把重复、乱序、堆积变成你必须正面回答的作业题。
为什么需要消息队列
假设下单接口要完成:写订单、扣库存、发优惠券、推送通知、更新画像。全部同步调用时,任何一个非核心服务变慢都会拉长响应,依赖也越连越紧。
引入消息后:
1 | 下单服务 ── OrderCreated ──→ Broker |
它带来三类价值:
- 解耦:生产者只发布事实,不必知道有多少消费者。
- 异步:非关键步骤离开用户请求链路,降低响应延迟。
- 削峰:流量峰值先进入队列,消费者按能力处理。
但 MQ 不是性能魔法。消息最终仍要被处理;若平均生产速率长期大于消费速率,队列只是在推迟崩溃。
两种基本模型
队列模型
一条消息通常由同一消费组中的一个消费者处理,多个消费者共同分担工作。适合任务分发,如图片转码、发送短信。
发布/订阅模型
多个订阅者各自收到同一事件,互不影响。适合“订单已创建”同时驱动库存、营销和分析。
现代产品常把两者组合起来:不同 Consumer Group 各消费一份;同一 Group 内的实例分摊分区。
还要区分两类产品心智:
- 传统消息代理:Broker 主动或按队列语义投递,消息确认后可删除,强调路由与低延迟。
- 持久化日志:消息按分区追加并保留一段时间,消费者维护 offset,可重放历史。
Kafka 更接近后者,RabbitMQ 更接近前者;RocketMQ、Pulsar 则吸收了两边不少能力。
一条消息的生命周期
1 | 业务事务 |
每个箭头都可能失败:发送超时但其实已写入、Broker 主节点故障、消费者处理成功却没来得及确认。因此“只执行一次”远比看起来困难。
消息设计建议使用稳定信封:
1 | { |
事件名用已发生的事实,Schema 要版本化。消费者不应依赖生产者数据库里的隐含字段。
投递语义
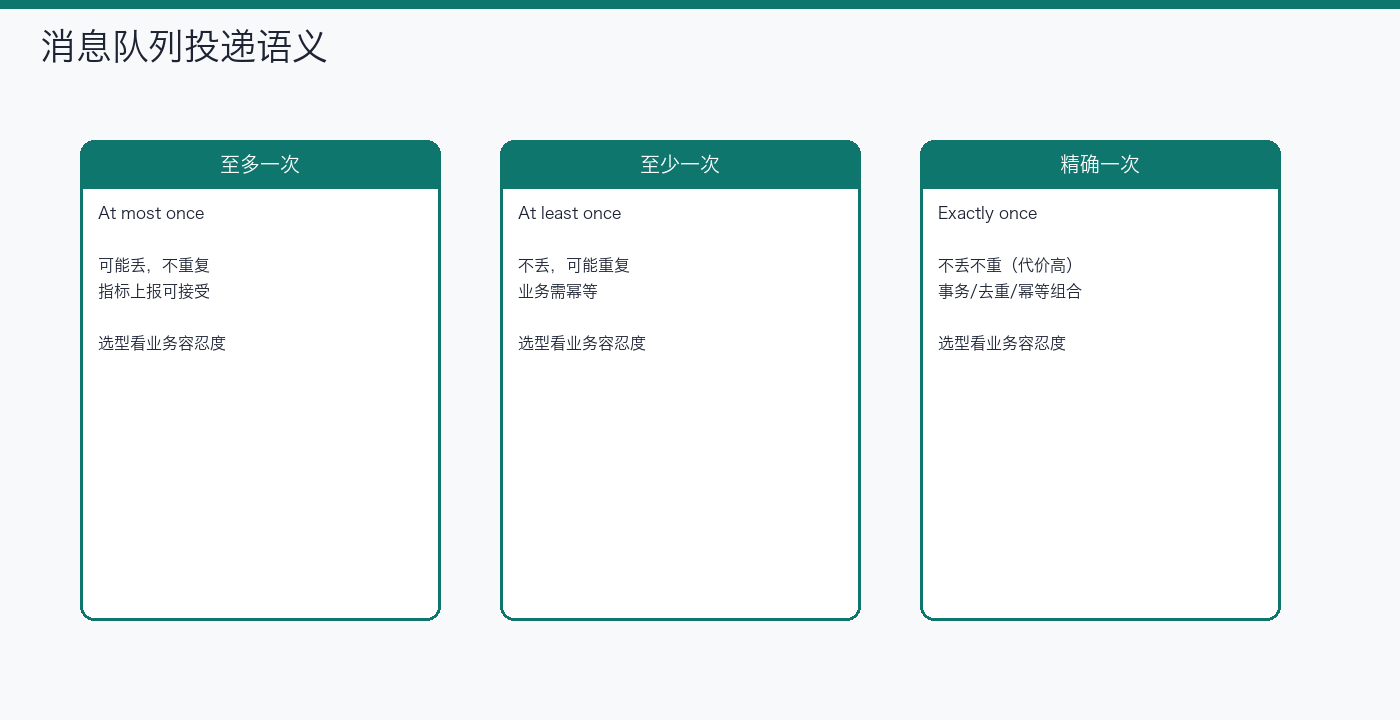
At most once:最多一次
消息可能丢,但不会重投。常见于先确认后处理,适合允许少量丢失的遥测数据。
At least once:至少一次
消息不会轻易丢,但可能重复。消费者处理成功、ACK 丢失时,Broker 会再次投递。多数业务系统选择这一语义,然后用幂等消化重复。
Exactly once:恰好一次
常被误解为“业务永远只执行一遍”。很多产品的 Exactly Once 只在特定边界内成立,例如 Kafka 事务可保证 Kafka 输入、状态和 Kafka 输出的一致,但无法自动保证“Kafka 消息 + 外部 MySQL + 第三方支付”全局恰好一次。
更实用的目标是:
至少一次投递 + 幂等消费 = 业务效果近似恰好一次。
消费者可以用业务唯一键或消息 ID 去重:
1 | BEGIN; |
去重记录与业务更新必须在同一事务里,否则两步之间崩溃仍会产生漏洞。
发送端的一致性难题
经典问题是“双写”:
1 | 先写数据库,再发消息:数据库成功后进程崩溃,消息没发。 |
常见解决方案:
Transactional Outbox
业务数据和待发送事件写入同一个本地数据库事务,再由后台任务或 CDC 把 Outbox 事件可靠投递到 MQ。它没有消灭重复,但避免了数据库与消息之间的丢失窗口。
事务消息
以 RocketMQ 为例,生产者先发半消息,执行本地事务后提交或回滚;Broker 在状态不明时回查生产者。它适合特定基础设施,但回查逻辑、幂等与异常状态仍需业务负责。
Kafka 事务
适合“消费 Kafka → 处理 → 再写 Kafka”的流式管道,将 offset 与输出消息原子提交。写外部数据库时仍需额外一致性设计。
顺序:通常只能局部保证
全局严格顺序会把系统压成单通道,吞吐和可用性都很差。常见做法是只保证同一业务键有序:
1 | partition = hash(order_id) % N |
同一订单进入同一分区,由同一消费组中的一个实例按序处理。注意几个坑:
- 多分区之间没有全局顺序;
- 重试若进入独立队列,可能与后续消息乱序;
- 扩分区会改变哈希映射;
- 消费者内部并发处理也可能打乱完成顺序。
如果业务可以依据版本号或状态机拒绝旧事件,就不必强求传输层绝对有序。例如只接受 version > current_version 的订单状态。
堆积与背压
队列堆积本质上是:
1 | 积压增长速度 = 生产速率 - 消费速率 |
排查时不要只看“积压条数”,还要看最老消息年龄、生产/消费速率、失败率、处理耗时和分区倾斜。
常见原因:
- 下游数据库或第三方接口变慢;
- 消费者发布后性能退化;
- 单条毒消息不断重试;
- 分区键不均匀,热点集中在一个分区;
- 消费实例少、批量参数不合理;
- 消息突然变大,网络与反序列化开销上升。
处理顺序通常是:先阻止继续恶化,再恢复消费能力。可以限流生产者、降级非核心事件、扩消费者、优化慢依赖、隔离毒消息。盲目扩容若瓶颈在数据库,只会把数据库打得更重。
必须设置:
- 重试次数与指数退避;
- Dead Letter Queue(DLQ);
- 最大消息大小;
- 消费超时;
- 队列容量或保留期限;
- 堆积年龄与失败率告警。
DLQ 不是垃圾桶。进入 DLQ 的消息要带原始消息、失败原因、重试次数和处理工具,并有明确负责人。
四类主流产品的直觉
| 产品 | 一句话直觉 | 常见优势 | 注意点 |
|---|---|---|---|
| Kafka | 可重放的分区提交日志 | 高吞吐、流处理生态、事件留存 | 分区顺序;路由能力较弱 |
| RocketMQ | 面向业务消息的分布式队列 | 顺序、延时、事务消息等能力完整 | 运维与生态要结合团队背景 |
| RabbitMQ | 灵活路由的传统消息代理 | Exchange 路由、低延迟、协议成熟 | 大规模历史留存与重放不是主战场 |
| Pulsar | 存储计算分离的多租户消息平台 | Topic 多、分层存储、跨地域能力 | 架构组件多,运维门槛较高 |
选型不要只看峰值 TPS。更重要的问题是:是否需要长时间重放?路由是否复杂?Topic 数量?跨地域?事务或延时消息?团队会运维哪个?托管服务能否降低成本?
常见误区
“用了 MQ 就解耦”
若消费者依赖生产者内部字段、事件随意改 Schema,依旧是强耦合,只是从 RPC 耦合变成消息耦合。需要明确事件契约、兼容规则和所有者。
“消息发送成功就完成了”
成功只说明到达某个确认边界。是否落盘、是否复制、消费者是否处理成功,要看具体 ACK 配置与监控。
“重试总能解决”
永久性错误重试一万次仍会失败。要区分瞬时错误与业务拒绝;后者应直接记录并进入人工或补偿流程。
“消息越大越方便”
大消息拖累网络、内存和重试。通常只传业务 ID 与必要快照,大对象存对象存储并传引用;同时考虑引用过期和一致性。
上线前检查清单
- 事件名称、Schema、版本和兼容策略是否明确?
- 生产端是否解决数据库与消息双写?
- 消费端是否以业务键实现幂等?
- 顺序保证的范围是什么?
- 重试、退避、DLQ 和人工重放如何工作?
- 是否监控发送失败、消费失败、lag 和最老消息年龄?
- 消息是否包含敏感数据,权限与保留期是否合理?
- 容量估算是否考虑峰值、消息大小、副本和积压恢复时间?
- 消费者发布与扩容是否会触发重平衡抖动?
- 故障时能否安全暂停、回放和追踪到原请求?
小结
消息队列把时间和空间上的依赖拆开:生产者不等消费者,消费者也可独立扩展。代价是你必须正面处理重复、乱序、堆积、契约和最终一致性。
好的 MQ 设计不追求一句空泛的“恰好一次”,而是明确每个失败窗口:哪里可能丢、哪里可能重、谁负责幂等、怎样补偿、如何观测。把这些答案写清楚,产品选型反而是后面较容易的一步。