最近会时不时看到或者听到 RAG。搞懂它之前,先弄清大模型真正缺什么——否则你会以为 RAG 是「让模型更聪明的魔法」,而不是「给模型外挂书架」的工程。
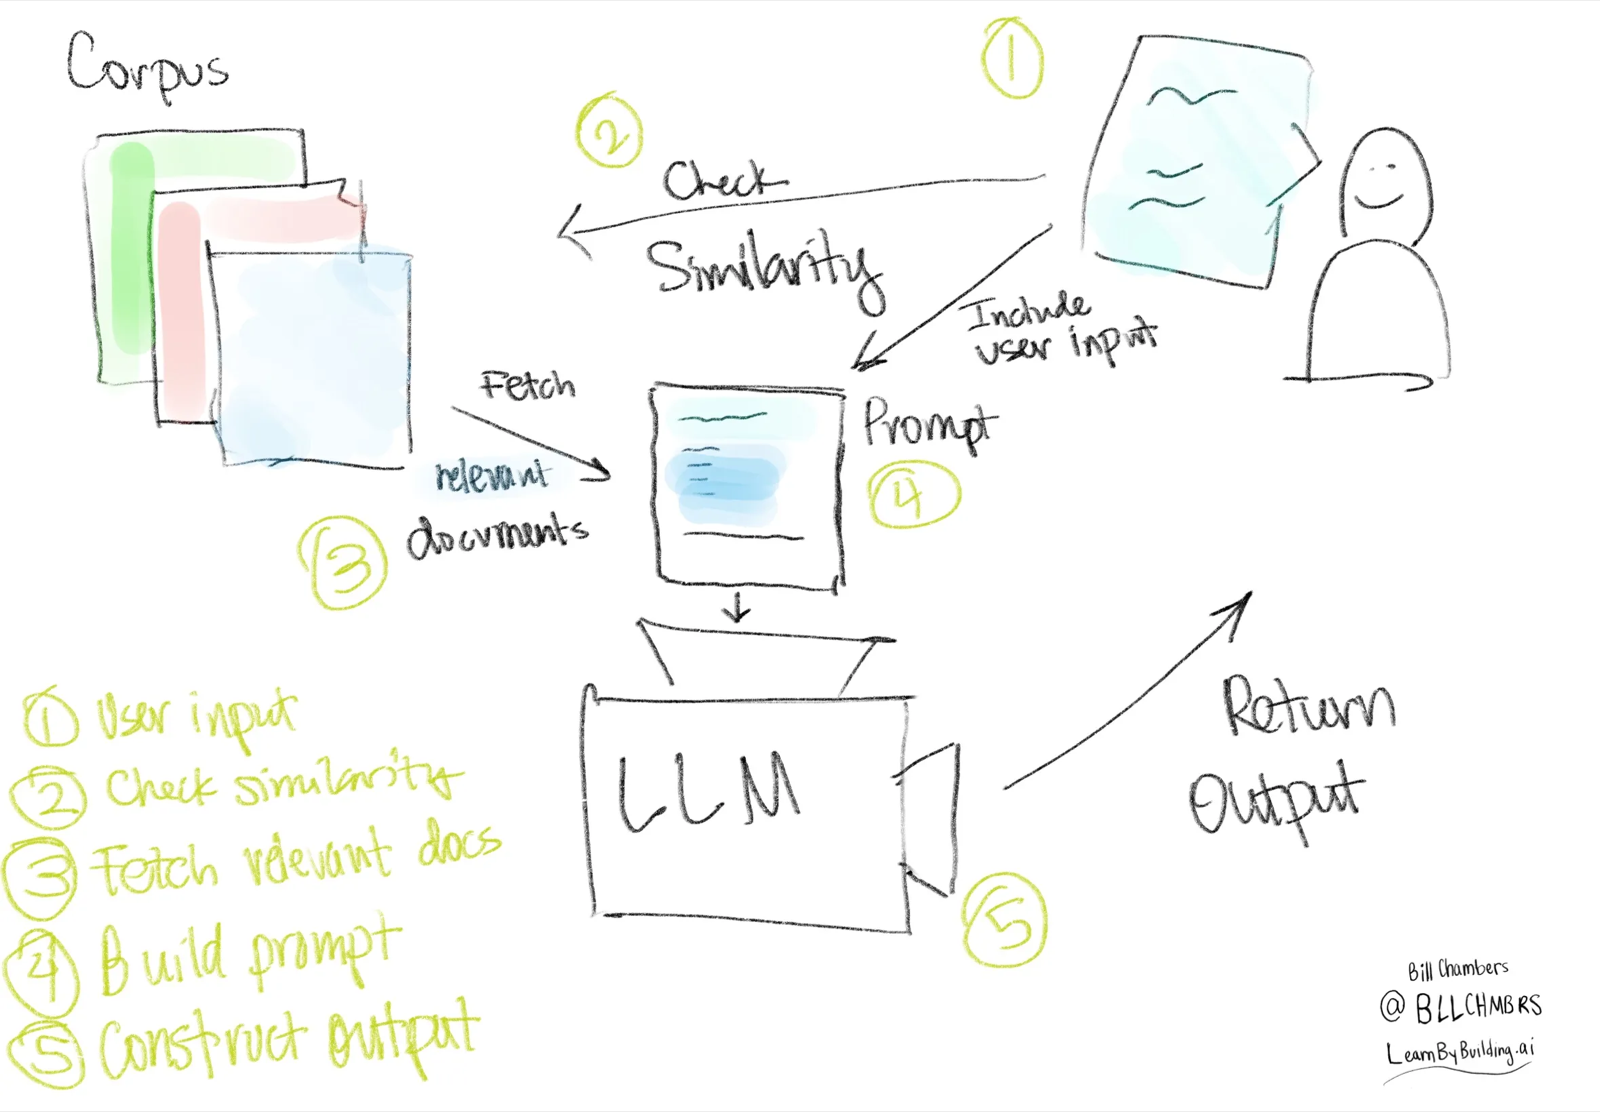
一句话:RAG = 先检索外部知识,再增强提示,最后让大模型生成——给 LLM 外挂一个可更新的「知识书架」。
为什么需要 RAG
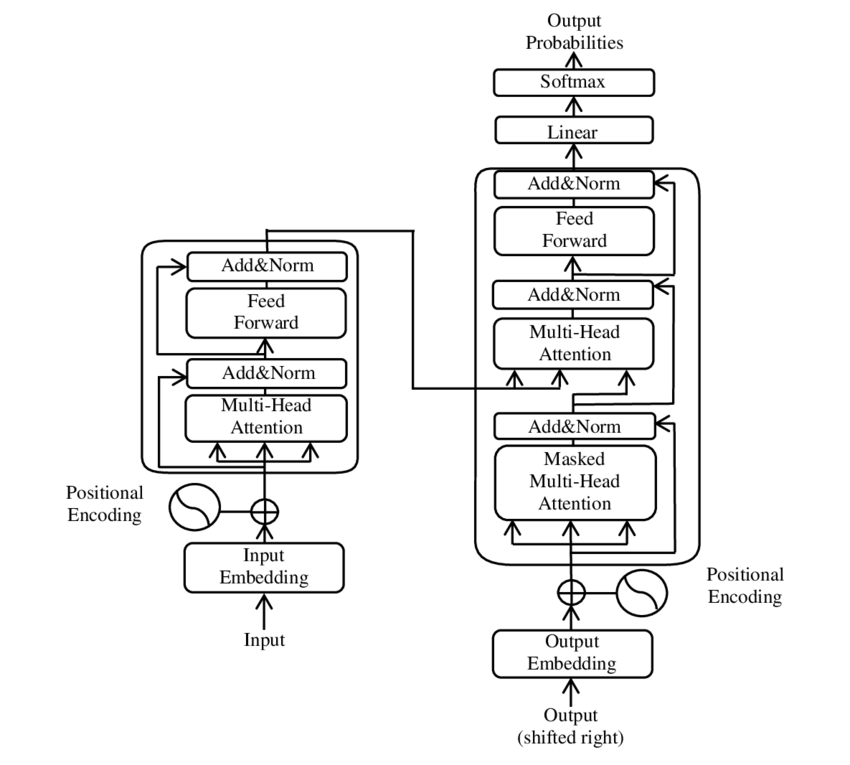
大模型(LLM)本质是自回归下一词预测:给定上文,猜下一个 token。训练目标是「像不像」,不是「真不真」。
所以它很擅长流畅表达、归纳改写、按格式输出;却很吃力于私有知识、最新信息、精确编号与条款。常见短板:
| 问题 | 含义 |
|---|---|
| 幻觉 | 说得一本正经,却没有事实依据 |
| 领域知识不足 | 没见过的内部规章、产品文档答不好 |
| 信息过时 | 知识截止于训练数据时间 |
| 上下文不稳 | 长对话里容易忽略或混淆细节 |
补救手段不是只有微调。对照一下:
| 手段 | 改什么 | 更适合 |
|---|---|---|
| 提示词 | 当次上下文 | 格式、语气、浅规则 |
| RAG | 外挂可检索知识 | 私有文档、常更新资料 |
| 工具 / Agent | 可执行动作 | 查库、算数、工作流 |
| 微调 | 模型权重 | 固定口吻、格式、特定技能 |
微调像「改脑子」,RAG 像「给书架」。知识常变、还要可追溯依据时,优先 RAG:更新资料不必重训,出错也能追到是哪段文本害的。
什么是 RAG
全称 Retrieval-Augmented Generation。论文脉络可追溯到 Facebook AI / Lewis 等人 2020 年前后:让生成模型访问非参数化的外部记忆(检索库),提升知识密集型任务的事实性。今天工业界说的 RAG,多已扩展成切块、向量库、混合检索、重排、权限、评测与观测一整条流水线。
和搜索对比:传统搜索返回链接,人自己点进去读;RAG 是 搜索 + 阅读理解 + 写答案,并把依据留在上下文里。
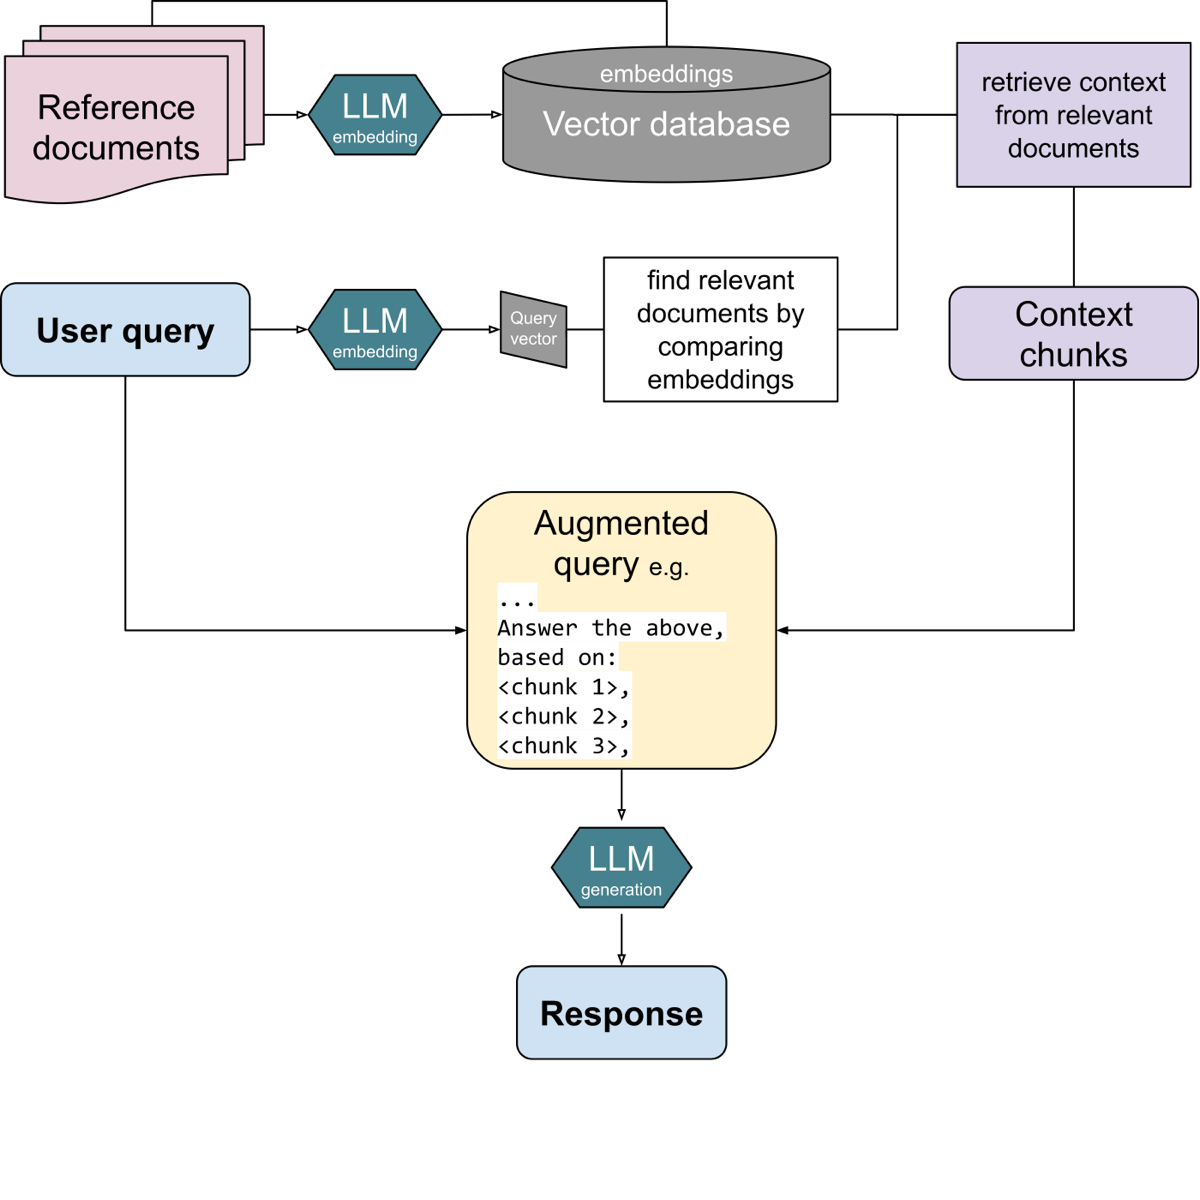
两个阶段:离线建库 vs 在线问答
1 | 【离线 / 索引】 |
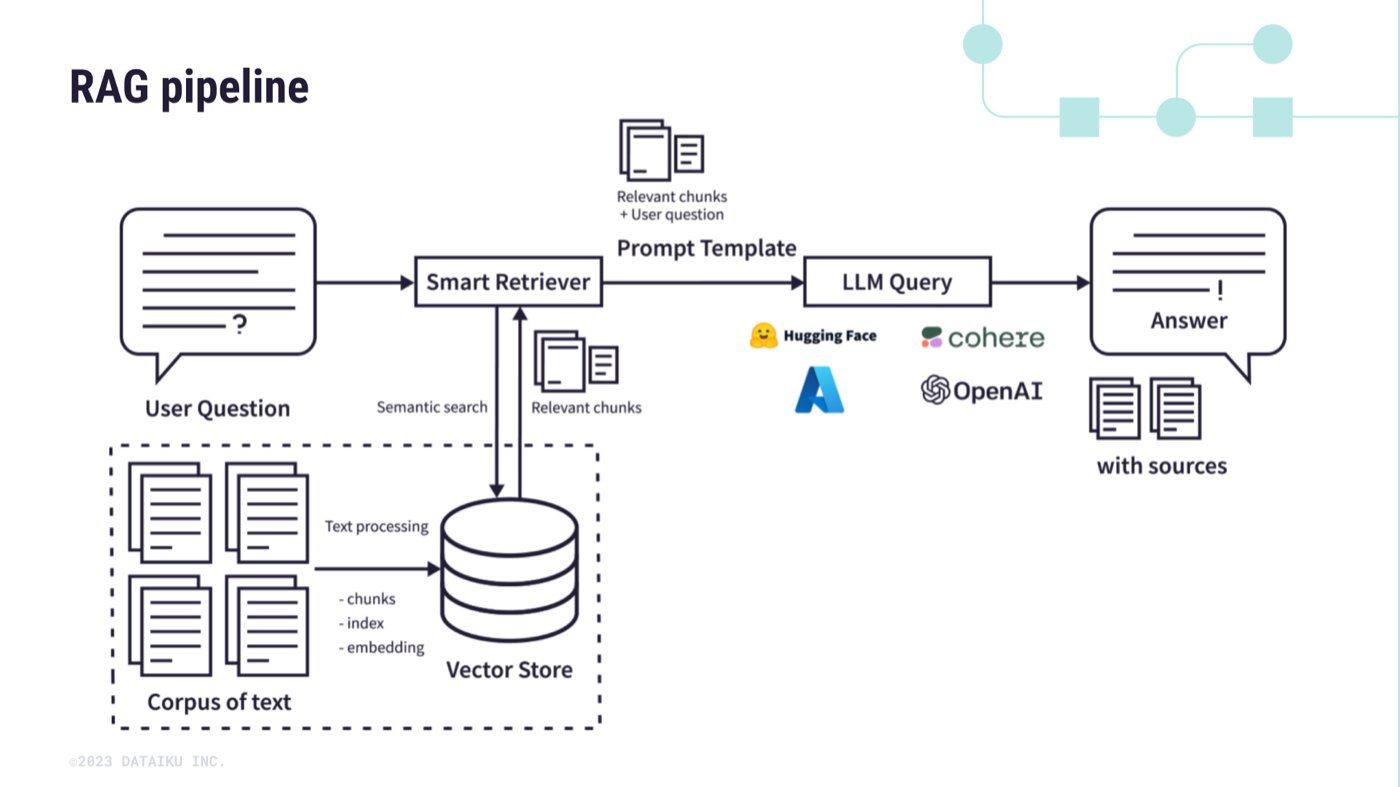
检索
从用户问题出发,到知识库、数据库或网页等来源里找出相关片段。现代 RAG 里,「相关」常常靠 向量相似度(语义相近),有时再叠加上 关键词检索(专有名词、编号更稳)。
生成
把检索到的片段当作「开卷考试的参考资料」,和用户问题一起塞进提示词,让 LLM 基于资料作答——而不是仅靠参数里的模糊记忆。
RAG 底层原理(把黑盒拆开)
Embedding:把文字变成可比较的向量
Embedding 模型把任意文本映射到固定维向量,使得 语义相近的文本在几何上靠近。你可以把它想成:把每句话钉到一张很高维的地图上;检索就是在地图上找离问题最近的那些钉子。
关键工程约束:
- 文档与查询必须用 同一套 embedding 模型
- 换 embedding ≈ 整库重建
- embedding 质量上限,基本也是检索质量上限
- 短查询、长文档块的向量分布可能不同,块太大时「平均语义」会变糊
还有一个常被忽略的点:相似度高 ≠ 足以回答问题。两段都在谈「宿舍管理」可能很近,但真正含「23:30」的只有一段。所以还要靠切块粒度、重排、以及生成侧的「依据是否足够」来兜住。
选择模型时,除了排行榜分数,最好用自己的 20 个问题做「检索命中」小实验:固定切块,只换 embedding,看 Top-K 命中率谁高。公开榜和你的手册语料不一定同分布。
余弦相似度:检索在算什么
常用指标是余弦相似度:
1 | cos(a, b) = (a · b) / (||a|| ||b||) |
若向量已 L2 归一化成单位向量,则 cos(a,b) = a · b,可用内积快速排序。向量库(FAISS、Milvus、Chroma、pgvector…)做的就是:在海量向量里快速找近邻。
下面用玩具向量直观感受一下(不是真实 embedding):
1 | import numpy as np |
切块(Chunking):RAG 里杠杆最大的旋钮之一
切块决定「系统能检索到的知识原子」长什么样。业界常说:如果你只打算认真拧一颗螺丝,先拧切块。
| 策略 | 说明 | 适用 |
|---|---|---|
| 固定长度 + overlap | 实现简单;注意句边界 | 快速原型 |
| 按标题 / 段落 / Markdown 结构 | 更贴文档结构 | 手册、Wiki |
| 语义切块 | 按语义边界切 | 效果更好,成本更高 |
| 父子块(小块检索、大块回填) | 检索用小块,生成带回父段 | 答案常跨段 |
经验起点(必须按语料调,没有圣杯参数):块大小常见 256–512 token,overlap 约 10%–20%。
- 太大:一段混多主题,噪声多
- 太小:缺上下文,答案割裂
- 答案跨两块:若单块不足以推出结论,检索再强也可能失败——这是表示层天花板
实操:优先按 ## 标题做结构切分,过长节再二次切;每块带上 source、section 方便引用。
元数据:别把过滤全交给向量
给每块挂上:来源文件、章节、日期/版本、学院或产品线、权限标签。查询时可先 filter 再向量搜,例如「只要 2025 版宿舍条例」。
没有元数据时,过期规章和新规章容易一起被检索到,造成上下文自相矛盾。
查询改写
用户问「几点熄灯」,文档写「断电时间」。可先让模型生成同义问法再检索,或维护一张领域同义词表。项目里一张同义词表往往就很管用。
混合检索与重排(进阶但仍该知道)
纯向量检索对 课程代号、法条编号、产品型号、工单 ID 经常翻车——这些更像「精确匹配」问题;BM25 等关键词检索对此更稳。反之,用户换一种说法提问时,向量又更擅长。
所以生产上常见组合不是二选一,而是流水线:
1 | 向量召回 Top-N ∪ 关键词召回 Top-N |
直觉分工:
| 阶段 | 目标 | 典型规模 |
|---|---|---|
| 召回 | 别漏掉含答案的块 | 每路几十条,合并去重 |
| 融合 | 两路结果合成一张候选表 | RRF 等 |
| 重排 | 把真正相关的顶上去 | 从几十压到 5–10 |
| 生成 | 基于精选上下文作答 | 受窗口与费用约束 |
注意:cross-encoder 重排 不适合直接扫百万文档;它是第二阶段精排器。有重排时,第一阶段可以取得稍宽,再交给重排「收网」。
先把「纯向量 + 好切块 + 拒答」做到可用;手册里专有名词多,再加关键词路,收益通常立刻可见。
提示词怎么写才像「开卷考试」
坏提示:「根据你的知识回答。」
好提示至少包含:
- 只能依据下列资料
- 资料不足就明确说不知道 / 资料中没有
- 给出引用(文件名、章节、短摘录)
4.(可选)若资料互相冲突,指出冲突并标明版本日期
RAG 降低幻觉,不 消灭幻觉。拒答能力要靠:提示约束 + 检索分数门槛 + 评测集一起守门。
评测:不要只报一个「端到端准确率」
端到端准确率只能告诉你「坏了」,很少告诉你「哪坏了」。至少拆成:
| 指标 | 看什么 |
|---|---|
| 检索命中率 | Top-K 是否包含应命中段落 |
| 回答正确率 | 最终答案是否可接受 |
| 拒答正确率 | 本该不知道时是否老实 |
| 引用正确率 | 引用是否真指向依据段 |
改切块或 embedding 时,先看检索命中率有没有涨;否则你可能在用「模型世界知识」冒充 RAG 成功。
离线索引流水线:一步步在干什么
很多人把 RAG 理解成「调一个 similarity_search」。真正决定上限的,往往是 索引怎么建。把离线流水线拆开看:
1. 采集与清洗
来源可能是 PDF、Wiki、Confluence、飞书文档、邮件、工单导出。清洗要干掉:
- 页眉页脚、水印、目录页的重复噪声
- 扫描件 OCR 乱码
- HTML 标签、无意义导航文本
- 明显重复的段落(同一规章粘贴了三遍)
脏数据进库,后面所有相似度计算都在「脏空间」里做近邻——再贵的模型也救不了。
2. 结构化与切块
手册类优先保留标题层级;表格尽量转成「字段: 值」句子,否则表格被切碎后语义全无。代码/配置片段要避免从中间劈开。切完后抽查 20 个块:人能不能只看这一块大致懂它在说什么?看不懂的块,模型也很难用。
3. Embedding 与入库
选择 embedding 时关注:
- 是否支持你的语言(中文效果差异可以很大)
- 维度与价格、延迟
- 是否与后续重排模型配套
- 版本钉死:今天
text-embedding-3-small,明天悄悄换别的,旧索引会 silently 变差
入库时务必写入元数据。没有元数据的向量库,像一座没有书架标签的图书馆。
4. 版本与更新
文档更新了怎么办?
- 全量重建:简单可靠,语料不大时首选
- 按文档 ID 删除再插入:适合单篇更新
- 别忘了:改了切块策略 ≈ 旧索引作废
给索引打上 corpus_version / built_at,线上出问题才知道「现在跑的是哪一版书架」。
一个正反对比:同一问题,两种上下文
用户问:「CS301 退课最晚什么时候?」
坏上下文(只靠语义,Top-K 漂了)
模型可能看到的是「宿舍断电」「图书馆开放」之类相近但无关的段,于是:
- 要么胡编一个日期
- 要么把「第三周周五」安到错误课程上
根因在检索,不在「GPT 不够聪明」。
好上下文(混合检索抓住课号)
BM25 因 CS301 命中含课号的块,RRF 把它顶上去;模型看到:
计算机学院核心课 CS301《操作系统》退课规则同上……开学第三周周五 17:00
再配合「只能依据资料」的提示,答案才站得住,并能引用原句。
演示时把「仅向量 / 仅 BM25 / 混合」三张榜投屏,比空讲架构图更有说服力。
生成侧还要做的几件事
检索只是把参考书翻开;生成侧仍可能翻车。
上下文组装顺序
常见做法:
- 系统规则(角色、拒答、引用格式)放前面,保持稳定
- 检索片段按相关性或文档结构排列,并标号
[1][2][3] - 用户问题放在资料附近,避免模型「忘记题目」
- 明确要求:先想依据编号,再写答案(有的团队会要求模型先输出引用列表)
片段不要无限堆:宁缺毋滥。5 段高质量上下文,往往好过 20 段噪声。
引用格式示例
1 | 答案:…… |
没有依据编号的「流畅答案」,一律视为不合格——这能逼着链路把检索做实。
多轮对话里的 RAG
第二轮用户说「那周末呢?」时,指代消解很重要:
- 把指代补全为「图书馆周末开放时间」再检索;或
- 把上一轮检索到的相关段保留在状态里(短对话)
最怕的是:多轮只追加聊天记录,却不再检索,模型开始用过期的「记忆」编。
RAG 解决了什么,又解决不了什么
适合
- 企业内部 Wiki / 制度 / 手册问答
- 课程讲义、论文库、产品文档助手
- 知识需要经常更新,又不想反复微调
- 需要可追溯引用的回答
不自动解决
- 检索错了,生成再强也是「戴着镣铐编故事」
- 需要多步推理、算数、写库——还要工具 / Agent
- 权限与安全:检索结果里的注入文本仍可能影响模型
- 「全书塞进超长上下文」:贵、慢,且注意力会被稀释
和相关概念对比
| 概念 | 和 RAG 的关系 |
|---|---|
| 微调 | 可互补:微调管行为,RAG 管知识 |
| Agent | 可把「检索」封装成工具,由模型决定何时查 |
| LangChain / LlamaIndex | 提供装 RAG 流水线的工程积木 |
| 长上下文模型 | 能多塞一些字,但不能替代优质检索 |
动手实践
下面按「先数学直觉 → 再最小可运行 RAG → 再对照题集」来。需要 Python 3.10+,以及 OpenAI 兼容 API(也可用本地 embedding + 本地 LLM,自行替换)。
1. 环境准备
1 | mkdir -p ~/rag-labs && cd ~/rag-labs |
1 | export OPENAI_API_KEY="sk-..." |
2. 准备一份迷你知识库
新建 campus_notes.md:
1 | # 校园手册摘录 |
3. 最小 RAG(切块 → 向量库 → 生成)
新建 rag_basic.py:
1 | from pathlib import Path |
跑通标准:
- 断电问题能答对,且明显依据资料
- 食堂问题不应编造菜单
4. 调试口诀:先看检索,再看生成
很多「RAG 不准」其实是检索阶段就错了。加上这段,把 Top-K 打出来:
1 | question = "宿舍平时几点断电?" |
如果这里片段就不对,优先改:切块、k、embedding、查询改写、元数据过滤——而不是先换更大聊天模型。
5. 可选:相似度门槛拒答
有的向量库能返回分数。思路是:最高分太低就直接拒答,不把噪声塞给模型。阈值要按你的 embedding 与语料标定,没有万能常数。
6. 最小评测集(比「我觉得挺准」有用)
新建 eval_questions.jsonl:
1 | {"q": "宿舍几点断电?", "expect_contains": ["23:30"], "type": "answer"} |
跑通时建议带上「应答对 / 应拒答」两类题,比只演示一次快乐路径更有说服力。
7. 常见翻车与排障
| 现象 | 优先排查 |
|---|---|
| 答非所问 | 先 print 检索结果;切块与 k |
| 专有名词检索失败 | 加关键词检索 / 混合检索 |
| 偶尔胡编 | 强化拒答提示;加分数门槛;要引用 |
| 换模型后全乱 | embedding 是否一起换了?索引是否重建? |
| 又贵又慢 | 块太大、k 太大、重复建索引、无缓存 |
排障口诀:先看模型看见了哪些资料,再怀疑模型智商。
8. 混合检索实战(BM25 + 向量 + RRF)
纯向量检索遇到「课程代号 CS301」「错误码 E_AUTH_4031」「宿舍楼 12 栋」这类 精确串 时经常翻车;BM25 关键词检索刚好擅长这个。反过来,用户把「断电」说成「熄灯」时,向量又更稳。
混合检索的目标不是「两路都完美」,而是 用不同偏置互相补洞,再用融合算法合成一张排序表。
先搞懂 RRF:为什么不用直接加分数?
向量相似度一般在 ([-1,1]) 或 ([0,1]) 一带;BM25 分数往往是另一套量纲。两路分数 不能直接相加。
RRF(Reciprocal Rank Fusion,倒数排名融合) 不管原始分数,只看排名:
1 | score(d) = Σ_i weight_i / (k + rank_i(d)) |
rank_i(d):文档 d 在第 i 路检索里的名次(从 1 开始)k:平滑常数,常用 60;k 越大,头部名次的优势越「温和」- 同一文档出现在多路结果里,分数会累加——这正是我们想要的「两路都觉得相关」
BM25 到底在干什么?(够用版直觉)
不必推导完整公式,记住三句话即可:
- 词频有用,但会边际递减:同一词重复一百次,不等于相关一百倍
- 稀有词更值钱:到处都有的「的」「是」权重低;「CS301」这种稀有串权重大
- 文档长度要归一:长文档更容易碰巧撞词,需要长度惩罚
所以 BM25 本质是 加权关键词匹配,不是语义理解。它不懂「熄灯≈断电」,但极擅长「字符串对得上」。
向量检索刚好相反:它把文字投到语义空间,近义能靠近,但可能把「CS300」和「CS301」搅在一起。
混合检索 = 让「懂意思的」和「认字的」一起投票。
扩充一点语料,方便看出差异
把 campus_notes.md 改成带「精确编号」的版本:
1 | # 校园手册摘录 |
可运行代码:手写 BM25 + 向量 + RRF
依赖多装两个包:
1 | pip install -U rank_bm25 langchain-community |
新建 rag_hybrid.py(刻意手写融合,方便看懂原理;不依赖 EnsembleRetriever):
1 | from __future__ import annotations |
跑完后建议对照三张榜:
q1语义问法:向量榜通常更贴「断电」段q2带CS301:BM25 榜更容易抓住含课号的块- 混合榜:两边优点更容易同时留下
这就是混合检索的直观价值:不是平均变强,而是减少「某一路系统性瞎眼」。
用 LangChain EnsembleRetriever(可选)
若你更想要框架封装,也可以:
1 | # pip install -U langchain-community langchain-classic rank_bm25 |
手写 RRF 比直接调 EnsembleRetriever 更值得先看:别人一问「两路分数怎么融」,公式就在眼前。
混合检索之后还可以接什么?
1 | 混合召回(宽)→ 去重 →(可选)交叉编码器重排(窄)→ 拼 Prompt → 生成 |
重排模型(cross-encoder / 云厂商 Rerank API)对「查询+文档」打分更准,但更贵更慢,只适合短名单。第一版可以不上。
RAG 的几种常见形态
| 形态 | 做法 | 何时用 |
|---|---|---|
| Naive RAG | 切块 → 向量 → Top-K → 生成 | 入门、语料干净 |
| Hybrid RAG | 向量 + BM25 + 融合 | 专有名词/编号多 |
| RAG + 重排 | 宽召回再精排 | 要更高准确率 |
| Agentic RAG | 模型决定是否检索、是否改写再查 | 问题类型杂、需多跳 |
| 图谱增强 | 实体关系 + 文本块 | 强结构知识、复杂关系问答 |
推荐路径:Naive → Hybrid → 评测过关 → 再考虑 Agent 化。不要第一步就 Multi-Agent RAG。
上线前还要知道的
安全与权限
检索把外部文本送进模型窗口,等于扩大了攻击面:
- 提示注入:网页/邮件/工单里写「忽略以上指令…」
- 越权读取:A 用户问到了 B 用户文档(没做 ACL 过滤)
- 敏感原文外泄:模型把资料原句抄进对不可信用户的回答
防护思路:检索前按身份做元数据过滤;把检索内容当 不可信数据;对外回答脱敏;高风险操作走鉴权与人工审批。
再补两条常被忽略的:官方手册 / 内部制度 / 爬取网页可信度不同,元数据里打 trust_level;索引重建要留审计(谁在何时构建了哪版索引)。
近似近邻:够用的不准
教科书里的相似度是精确两两比较;百万、千万级向量时会用 ANN(HNSW、IVF 等)用近似换速度。原型阶段内存精确搜就够;生产上近似更激进、量化压缩、过滤策略都会偷召回率。「本地 Demo 很好、上线千万文档就变差」——不只是语料变了,检索配置也可能变了。评测时线上线下用同一套检索配置说话。
评测小脚本(示意)
有了 eval_questions.jsonl,可以用非常朴素的脚本做回归:
1 | import json |
粗糙,但能拦住「改切块改炸了却不知道」。可再加 must_hit_keyword 列,把检索命中率和生成正确率分开看。
从 Demo 到能用
- 语料质量:清洗页眉页脚、重复段、扫描噪声、乱码
- 切块策略:优先按结构切,保留 overlap,记录元数据
- 元数据与权限:该过滤的先过滤,避免越权与过期文档混入
- 检索宽度 + 重排:难例再上混合检索与重排
- 生成约束:开卷考试提示 + 引用 + 拒答
- 评测集:命中率、正确率、拒答率分开看
- 更新机制:文档变更后如何增量/全量重建索引
- 观测:每次问答记录检索片段与最终答案,方便复盘
建议落地顺序
- 划定问答边界 + 准备 15–20 条黄金题(含拒答、含编号题)
- 清洗资料,跑通最小向量 RAG
- 调切块与 k;强制打印 Top-K
- 强化拒答与引用
- 上混合检索,对比三张榜,更新评测表
- 需要演示时再加 Gradio / Streamlit
若还要「有时检索、有时算数」,把检索封装成工具接到 Agent——见《什么是LangChain?》。
FAQ
Q:上下文窗口都 128K / 1M 了,还要 RAG 吗?
A:要。窗口大不等于该把整库塞进去:贵、慢,而且注意力会被噪声稀释(context rot)。RAG 的价值是「每次只塞相关的一小撮」。超长上下文更适合「已经检索到的中等篇幅材料」,而不是替代检索本身。
Q:RAG 能 100% 消灭幻觉吗?
A:不能。它把考试从闭卷变成开卷;开卷仍可能读错、抄错、脑补。所以要拒答、引用和评测。
Q:一定要向量数据库吗?
A:几十上百页手册,内存向量库足够学习;上生产、要持久化、过滤、海量近邻,再换 Chroma / pgvector / Milvus / Qdrant 等,检索心智类似。
Q:微调是不是更高级?
A:不是替代关系。知识常变用 RAG;口吻/格式要「长在模型身上」再考虑微调。很多系统两者都用。
Q:检索到了但答案仍错?
A:检查:片段是否真进了提示、提示是否允许胡编、Top-K 噪声是否太大、是否需要重排、资料本身是否写错。
Q:混合检索一定比纯向量好吗?
A:不保证。语料全是散文、几乎无编号时,BM25 增益有限,还可能引入噪声。用评测集说话:专有名词题涨了没有?普通语义题掉了没有?
Q:RRF 的 k=60 能改吗?
A:能。k 越小,更偏向各路的第一名;k 越大,排名差异被抹得更平。先用 60,再在你的题集上扫几个值。
Q:中文 BM25 分词很烂怎么办?
A:Demo 用「单字+英文 token」只为跑通;认真做请上 jieba / pkuseg,或走支持中文的搜索引擎(ES 等)当关键词路。
Q:Agentic RAG 和普通 RAG 怎么选?
A:问题类型单一、资料边界清晰 → 普通/混合 RAG 更稳。需要「先判断要不要查、查不够再改写再查、偶尔用计算器」→ 再 Agent 化。
Q:和《什么是LangChain?》怎么分工?
A:本文讲检索增强范式与评测;那边讲编排、工具与 Agent。先懂 RAG,再装框架,不容易变成调包侠。
带走什么
心智模型
- LLM 会流畅续写,不保证真实
- RAG = 检索 + 增强提示 + 生成;检索错了,生成救不回来
- 切块与语料质量,往往比「换更大聊天模型」更值钱
- 向量擅长语义,关键词擅长精确匹配;融合用 RRF,别硬加分数
- 要拒答、要引用、要分阶段评测;先 Naive/Hybrid 过关,再 Agent 化
典型翻车
- 答案碰巧对了、依据是假的 → 强制引用 + 检索命中检查
- 语义近、课号错(CS301/CS300)→ BM25 / 混合检索或元数据过滤
- 注入与越权 → 来源白名单、ACL、检索文本当不可信数据
常见误区
窗口更大 ≠ 可以不检索;换更大聊天模型救不了检索漂;换 embedding 必须重建索引;Top-K 不是越大越好;「别编造」代替不了拒答评测;不看 Top-K 就调参等于盲调;一上来 Multi-Agent RAG 多半是过早优化。
小结
RAG 不是新模型,而是给 LLM 外挂可更新、可追溯的知识通路:先检索,再生成,用证据约束输出。
资料与切块 → 检索命中(必要时混合)→ 拒答与引用 → 分阶段评测 → 再考虑 Agent / 重排。
调参先看 Top-K,再看最终文案。编号类问题单独测。下一站可接《什么是LangChain?》。
参考文章
- 什么是 RAG(检索增强生成)? - Elastic
- Retrieval-Augmented Generation - Pinecone
- Hybrid Search with Reranking - Qdrant
- EnsembleRetriever(RRF) - LangChain
- RAG diagram - Wikimedia Commons
- The Transformer model architecture - Wikimedia Commons
- 延伸阅读:本博客《什么是LangChain?》
配图来源
- 文首封面与流程示意:社区图源转 PNG + Wikimedia RAG diagram
- Transformer 结构图:Wikimedia Commons